DACon 2026 北京站回顾|Mind Studio:企业知识如何成为 Agent 可直接调用的底座
2026-10-29 17:02:02
DACon 2026 北京站回顾|Mind Studio:企业知识如何成为 Agent 可直接调用的底座
网易智企·云商 | 网易智企-云商 | 2026年10月26日 15:20
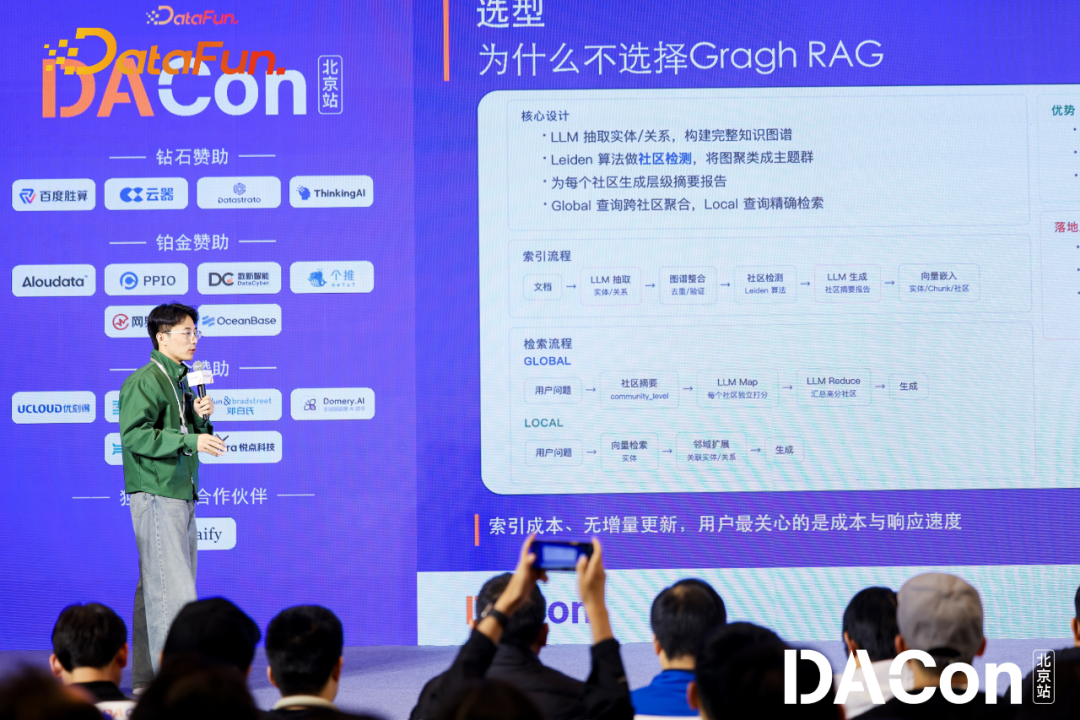
10 月 23 日至 24 日,DACon 2026 北京站, 企业本体与知识工程专场 中,网易智企·云商智能化资深产品经理王光宇带来演讲《从知识加工到知识治理:企业知识如何成为 Agent 可直接调用的底座》。
网易智企·云商 Mind Studio (网易智企 AI 知识库)是网易智企旗下的企业级 AI 知识库,面向 Agent 服务的垂类知识库,用 「三层检索 + 知识图谱」 让企业知识找得到、找得准,为 AI Agent 提供可控、可信的知识底座。
这场分享没有从模型开始,而是从 一个很小的问题 开始。这也是 Mind Studio 在客户项目中反复遇到、也最值得先解决的问题。
企业从来不缺内容,缺的是一套能认出对象、接上关系、回到证据的导航体系。
—— 网易智企·云商
用户问:“A2 Pro 的滤芯多久换一次?”知识库却召回了 A1 Pro 的维护章节 。
答案语句通顺,内容也来自真实文档。单看那段话,几乎挑不出毛病。但 对象从一开始就错了 ,业务自然不敢用。
这正是很多企业知识库的现状:内容不少,检索也能返回结果,但 Agent 进入业务之后,答案还是会出现 “看起来对、实际上不对” 的情况。
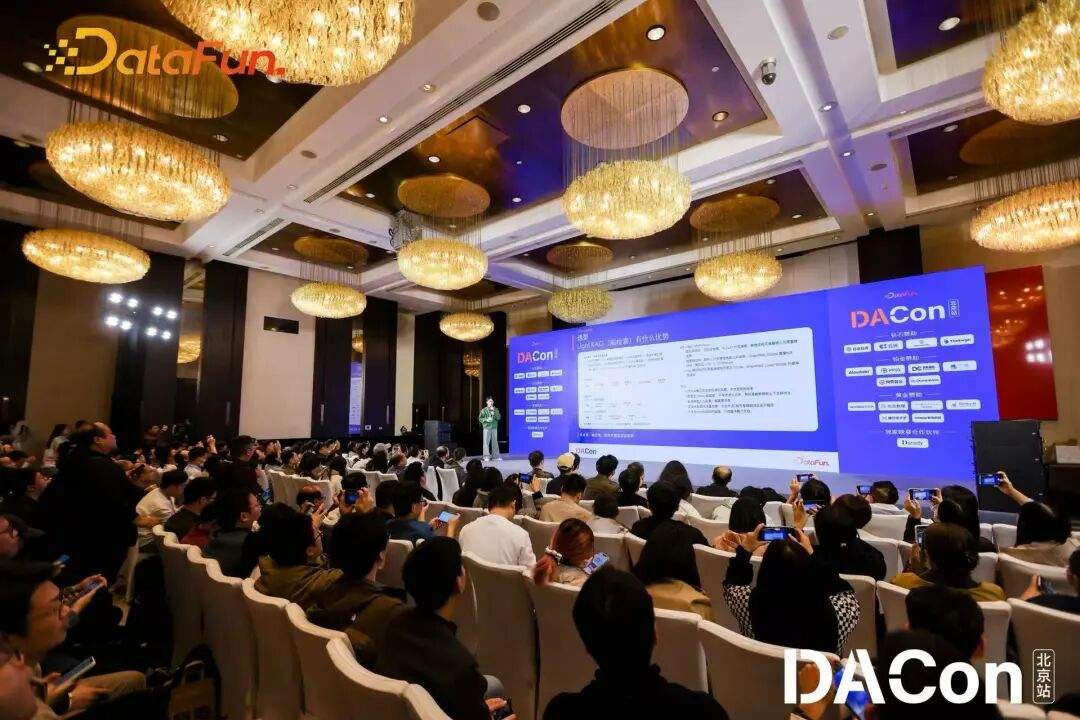
问题到底出在哪?
本文看点
01 三种断点 02 本体落成词库 03 知识飞轮
01 一道错题,暴露三种断点
第一种,是 对象错位 。
A2 Pro 和 A1 Pro 只差一个字符,文本相似度很高。系统如果只按 语义相近程度排序 ,就可能把两个型号混成一个。
第二种,是 关系断开 。
问“解除配对后哪些功能失效”,答案可能同时涉及通知、世界时间、自动校时等几个章节。单段都不够像问题,但 背后的影响关系必须一起取回 。
第三种,是 别名失配 。
用户说“红腰子”,正式商品名却不一定这么写。口语、旧称、错字和行业黑话 没有回到同一个对象 ,检索从第一步就偏了。
三种现象指向同一个结论:「企业知识已经进库,不等于能被 Agent 稳定调用。」
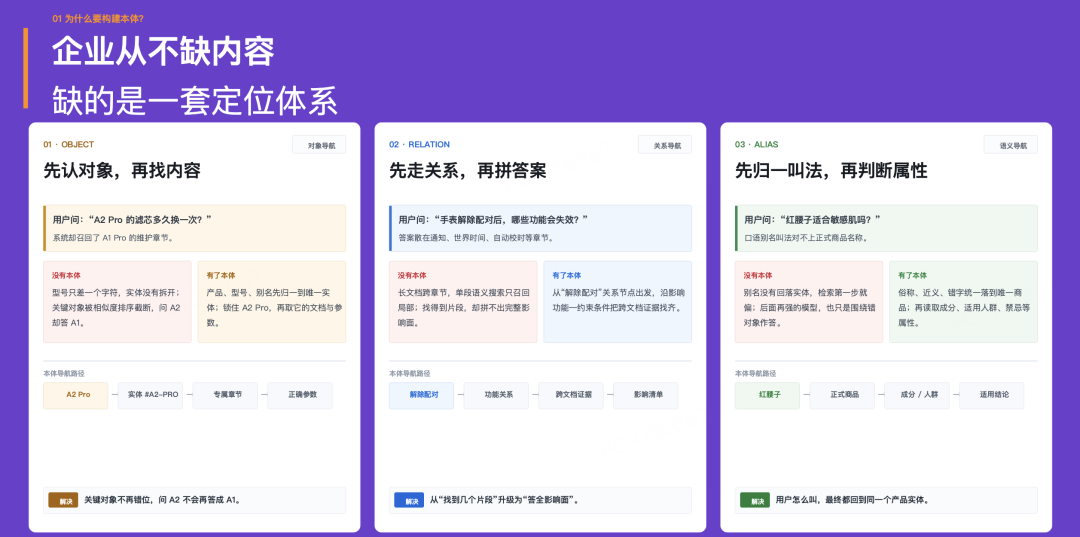
怎么定位问题
Mind Studio 不是把客户问题直接丢给一层检索,而是先把对象、关系、别名三类断点拆开诊断,再决定知识接入、词库和多路召回怎么组合。 先定位对问题 ,后面的产品能力才不会用错地方。
02 本体是概念词,我们选择合并为词库
这里把口径说透:本体是行业里的概念性词,很容易被理解成一张概念关系图;但在我们的产品里将它 合并成了“词库” 。
本体是以 实体 ID 为锚点 ,落在两件事上:
1. 给同一个业务名称提供一个稳定的 ID;
2. 把业务名称的各种叫法挂到这个 ID 上,形成词库且绑定互相关系。
后文沿用“本体”作为对外表述;具体建设、检索和维护的,都是词库。
标准名、别名、口语、缩写、错字和黑话都可以是入口,但最后必须回到 同一个 ID 。关系连接的也是 ID 与 ID,不是词与词之间。
A2-Pro、A2pro、A2Pro 滤芯,最终都落到 ID=22 ;A1 Pro 则必须是另一个独立实体。哪怕两者看起来很像,也 不能为了省事自动合并 。
但词库不是所有企业的第一站。
如果知识主要是 FAQ、制度、产品说明和参数表,答案能在单篇内闭环,通用 RAG、混合检索加工具取数,往往已经能覆盖绝大多数场景,效果可能达到 80%~90% 。
真正需要词库的,是 知识持续增长、问题高频、错误成本高 同时出现的时候。那时再升级,不是提前为所有未来付费,而是承认现有检索已经接不住业务。
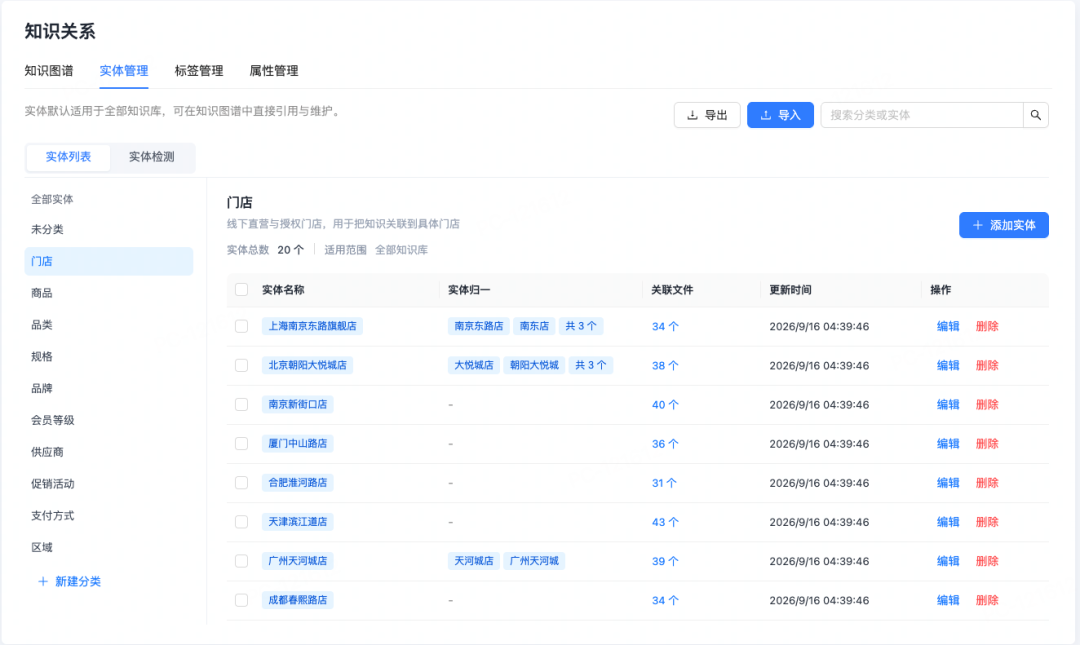
怎么建词库
Mind Studio 把本体做成可建设、可审核、可维护的词库:实体 ID、标准名、别名、关系词、标签词和约束词统一管理。客户拿到的不是一张概念图,而是能直接支撑 检索、权限和追溯 的知识资产。
03 客户的词库,不是模型自己长出来的
客户的词库从哪里来?现场给出的方案是三段式。
30% 业务条件
40% 自动化流水线
30% 业务约束
业务团队先告诉系统 什么词能抽 、哪些是行业内部说法;
自动化流水线完成 解析、抽取、分组和合并 ;
最后回到业务侧,回答三个问题:
1. 这些叫法是不是同一个 ID?
2. 两个近似对象是否必须拆开?
3. 这条关系有没有原文依据?
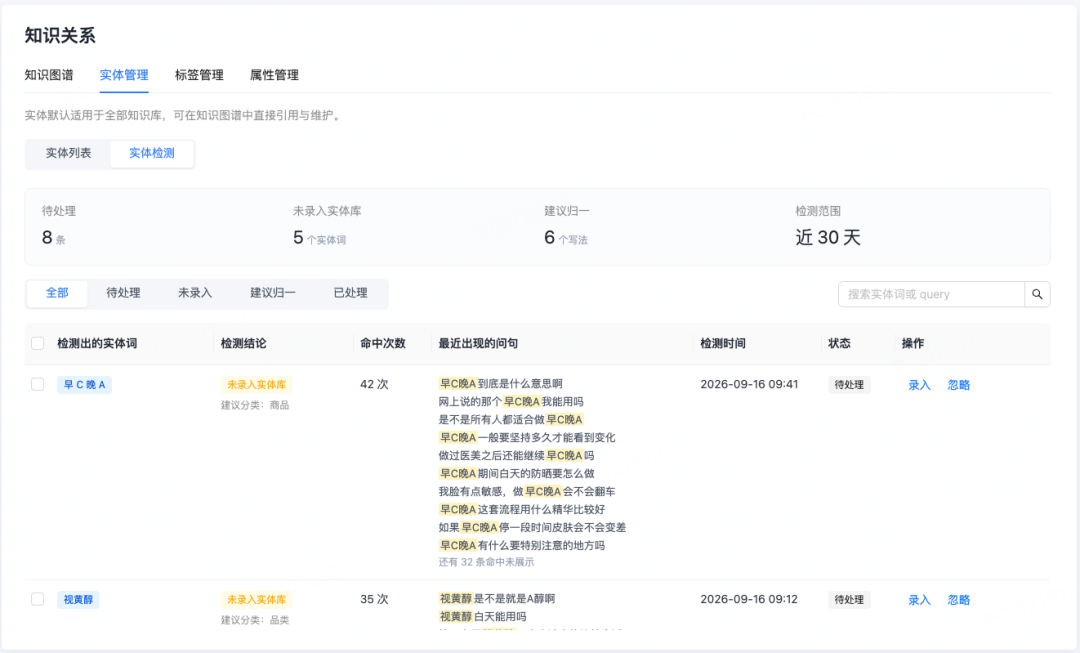
最后提供的不是模型生成的漂亮图谱,而是 业务确认过口径、版本的企业词库 。
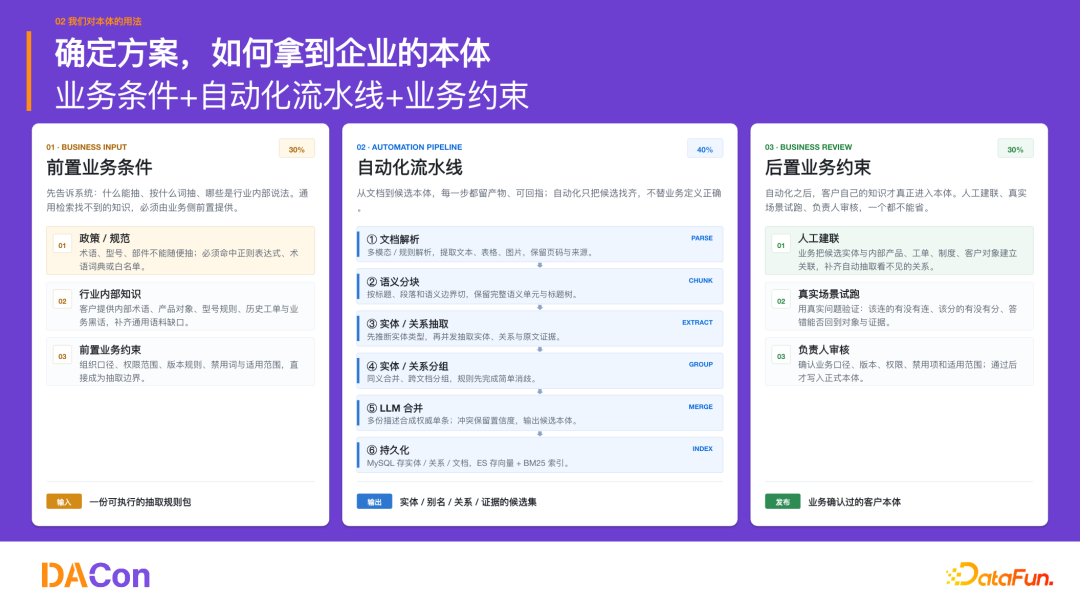
怎么交付词库
业务条件 30%、自动化流水线 40%、业务约束 30%,不是纸面方法,而是 Mind Studio 在客户项目里跑通的交付链路: 规则前置、自动抽取、人工审核 ,最后把客户口径固化进词库。通用模型负责抽候选,真正难懂的业务约束由产品和交付一起补齐。
04 词库进入业务,靠的是知识工程
词库建好,不等于业务就能用。知识进不来、切不好、路由不对、查不清,再好的词库也只是 离线资产 。
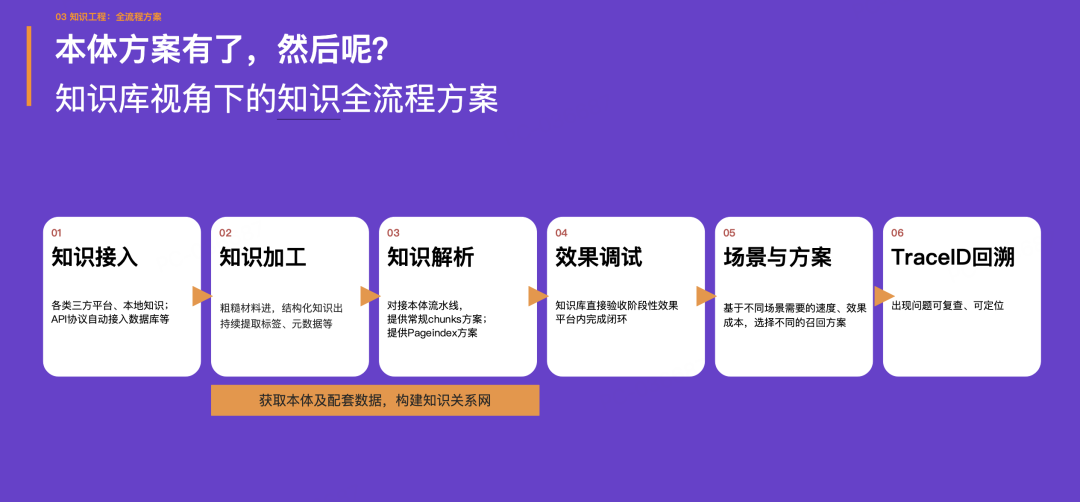
知识工程要走完六步: 接入、加工、解析、调试、路由和回溯 。精确事实先圈字段取值;长文档按章节和页码定位;型号关系和跨文档问题沿实体关系补证据;通用问答用切片、关键词和向量兜底;全过程用 TraceID 保留召回路径。
这里有一个很重要的原则:
「不是所有问题都强行走图谱。」
词库负责在需要的场景里 对齐对象、补关系、补约束 ;通用问题仍然走成本更低、速度更快的链路。
怎么接进业务
Mind Studio 支持从接入、加工、解析到多路召回和 TraceID 回溯的完整链路,精确问答、长文档、跨文档关系和通用问答可以走不同路径。产品力不在把所有问题都推上图,而在 把合适的技术放到合适的业务问题上 ,还能查得清。
05 上线不是终点,知识飞轮才刚开始
企业知识不会停在交付当天。政策会更新,产品会迭代,型号会增减, 业务口径也会调整 。
所以,飞轮先做治理,再做回流:重复内容先清,多版本先合并,过期知识自动下线,新叫法不管能不能和已有 ID 合并,都会 交给用户确认 ,避免造成歧义。
然后把真实业务数据拉回来:业务问答、智能诊断、人工确认、回流、再加工、再解析。
最后用 同一批问题、同一套知识、同一评测口径 复跑。
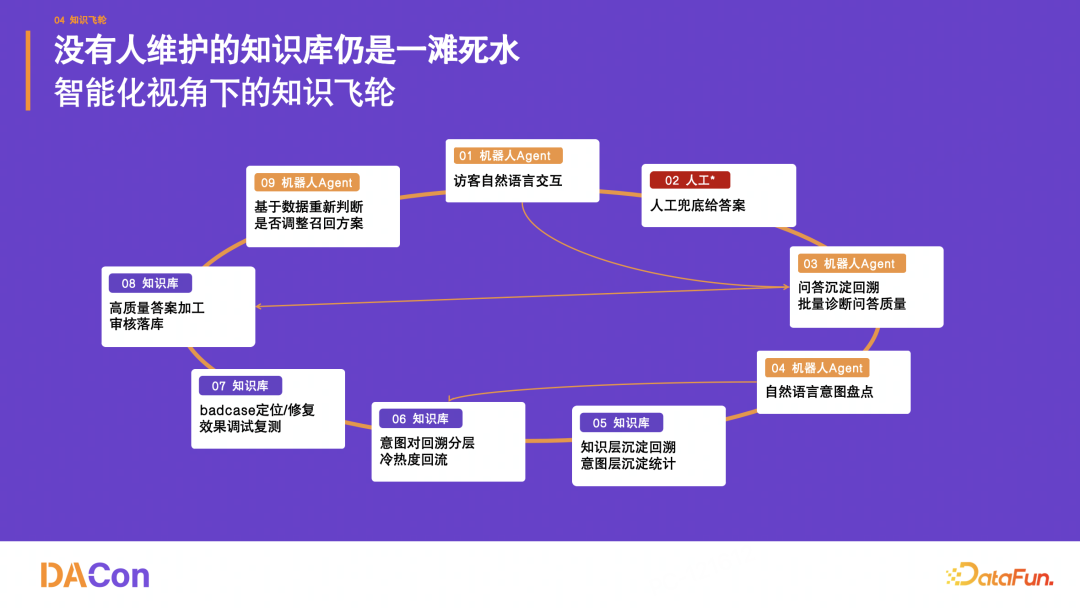
在 Mind Studio 的实际项目里,图谱关联准确率从 55% 提升到 88%。这 33 个百分点,没有换更强的模型,中间隔着 词库、工程、治理和回流 。
88% 图谱关联准确率,原 55%
85%+ 知识命中率
90%+ 引用可追溯率
怎么验收长期效果
Mind Studio 已经把治理、badcase 回流、同口径复跑和指标验收做成可持续运营能力。实际项目中,图谱关联准确率达到 88%,知识命中率 85% 以上、引用可追溯率 90% 以上、检索响应控制在 3 秒以内。客户得到的不是问答入口,而是 一套能持续变好的知识系统 。
06 这场分享留下的三个判断
第一, 不要先上 Agent,再补知识 。
编排得再顺,召回的也可能是错对象和断关系。
如果这个 Agent 强依赖知识,那它的上限,是由能不能拿到正确、完整、可追溯的知识决定的。
第二, 不要为了少数复杂场景,给所有简单知识做重 。
简单业务先用低成本链路跑起来,拿到 80%~90% 的结果。
等知识量增加、问题变复杂、错误成本变高,再升级词库。
前面跑出来的结果不是沉没成本,而是升级的起点。
第三, 不要把知识库当成一次性交付物 。
它不是一个建完就封存的仓库,而是一套需要持续治理、回流和验收的运行系统。
怎么分阶段落地
Mind Studio 交付的不是一套只能演示的知识库,而是从知识诊断、词库建设、知识工程到长期运营的完整方案。先让简单业务跑出 80%~90%,到复杂度拐点再升级,这条路已经在真实项目中走通:既控制前期投入,也给后续增长留足空间。
写在最后
企业从来不缺内容。
缺的是一套让 Agent 找得到、找得准、答得全、追得回 ,还能长期跑下去的知识底座。
这也是 Mind Studio 持续打磨知识库产品的原因。如果你也在处理复杂知识、Agent 落地或知识库长效运营的问题,欢迎交流。
关于我们
原文链接:https://mp.weixin.qq.com/s/-6O9ApNqfYWhZbCrkzYOrQ